文章目录
此笔记是在阅读
<<A Gentle Introduction to Graph Neural Networks>>的过程中写下的
阅读文章的同时观看了B站UP主跟李沐学AI的视频零基础多图详解图神经网络(GNN/GCN)【论文精读】
文章链接 :A Gentle Introduction to Graph Neural Networks
视频链接 :零基础多图详解图神经网络(GNN/GCN)【论文精读】_哔哩哔哩_bilibili
0. 标题解读 #
0.1 主标题 #
A Gentle Introduction to Graph Neural Networks
直接说明本文是关于 图神经网络(GNN) 的简单的介绍
0.2 副标题 #
Neural networks have been adapted to leverage the structure and properties of graphs. We explore the components needed for building a graph neural network - and motivate the design choices behind them.
讲的是 : 图神经网络 被用在处理图的结构和特效上, 这篇文章来探索构建图神经网络需要哪些模块, 以及这背后的思想是什么
0.3 副标题下方的交互图 #
当我们点击layer2中的一个节点, 可以看到图中显示, 这个节点是由它的下一层, 即layer3, 中自己的节点以及邻居所贡献而来
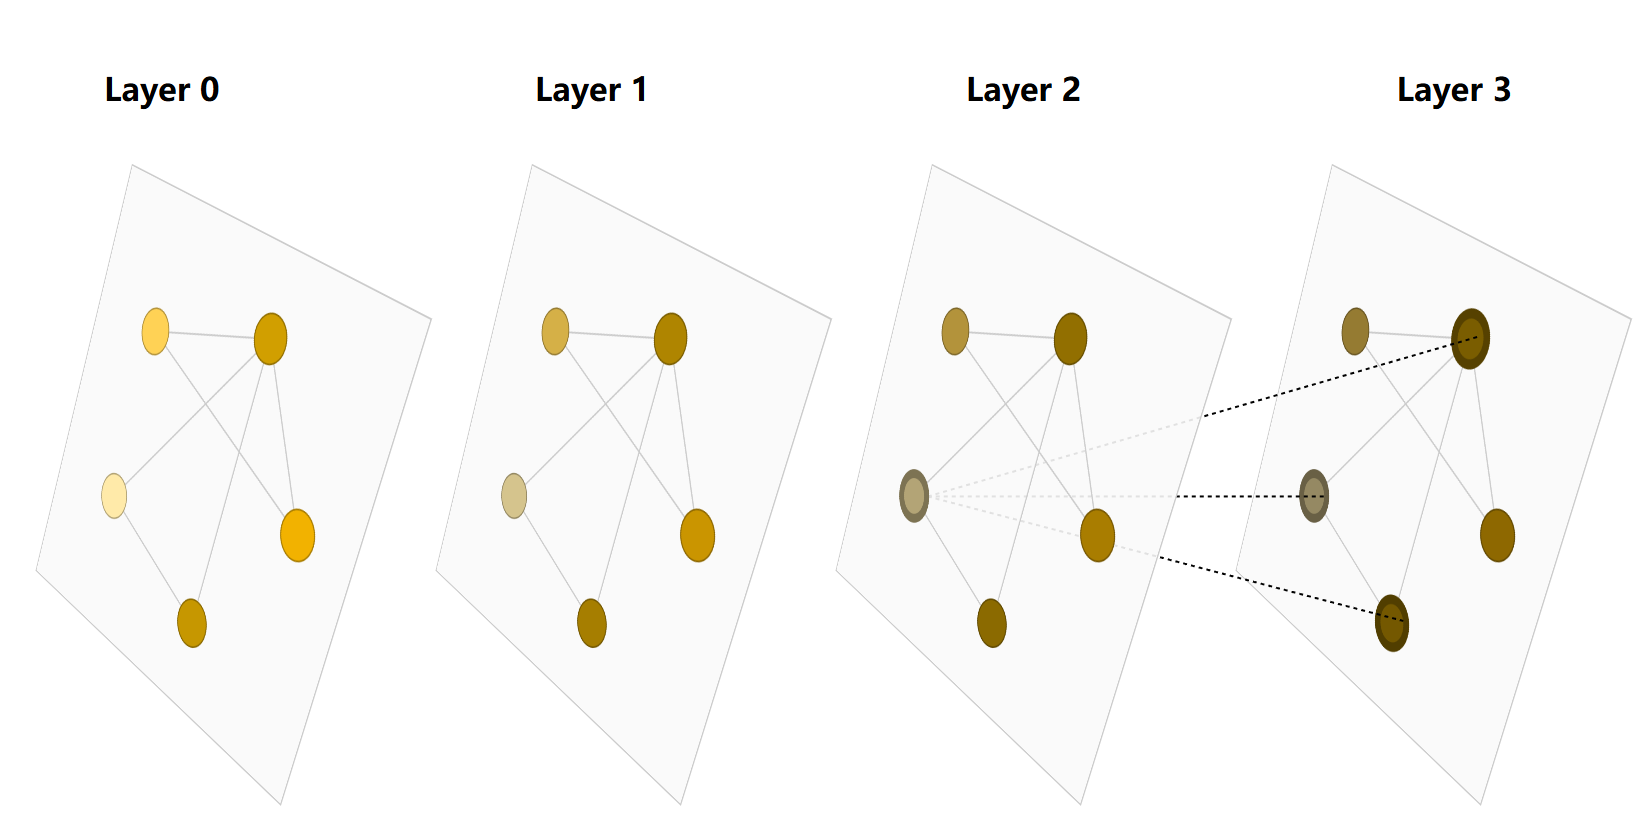
同样的, 再往上走一层就可以看到layer1中的节点有layer2中对应的节点贡献而来, 而layer2中的节点又关联到layer3中的节点
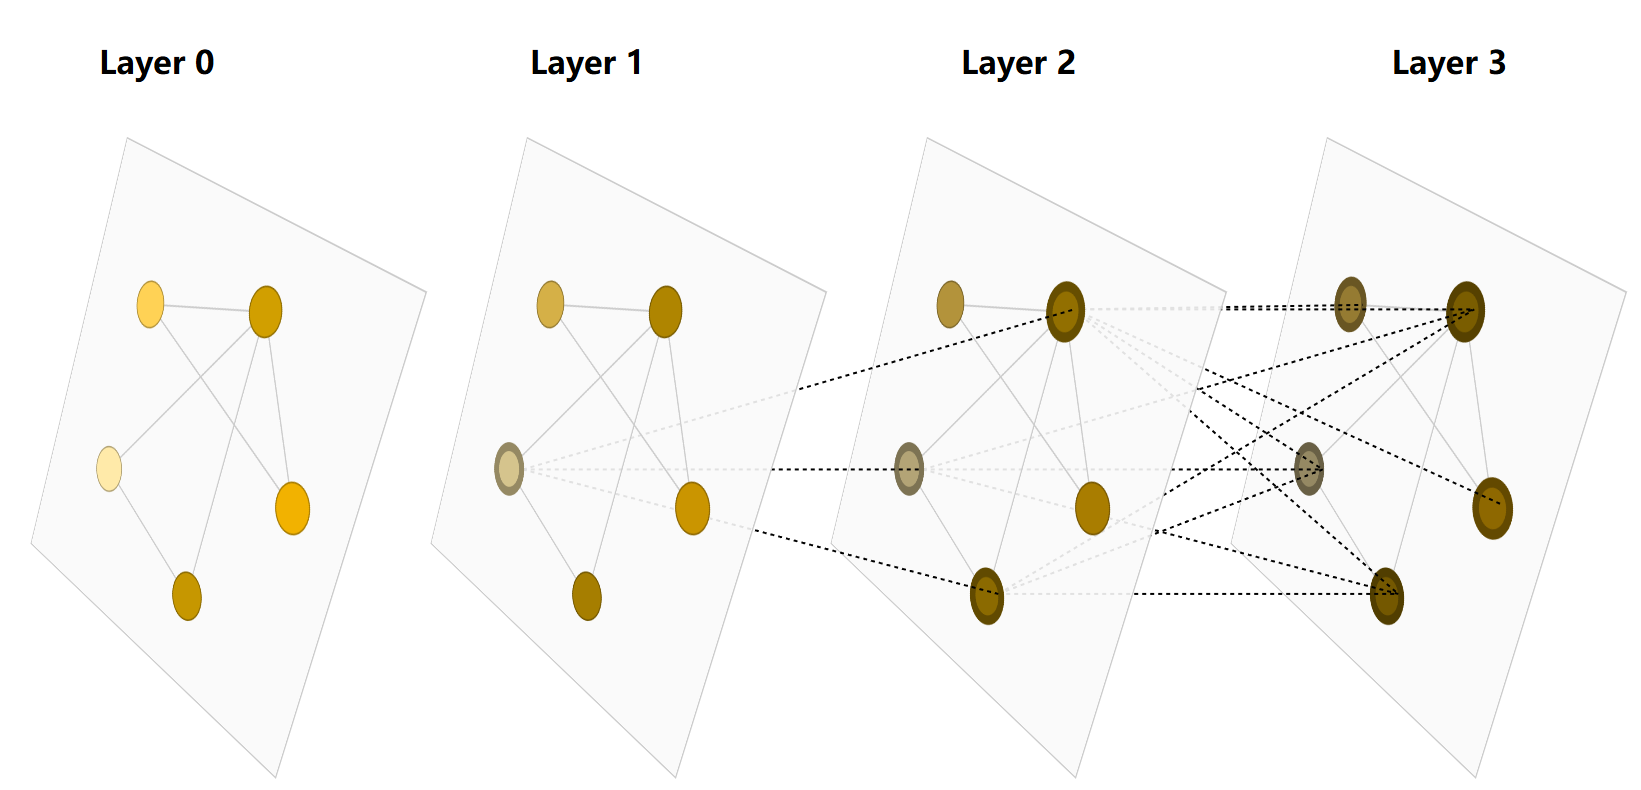
这个交互图简单表示了图神经网络是怎样利用图的结构化信息来处理信息的
1. 作者信息及文章信息 #
不做了解, 我选择略过
2. 引入 #
2.1 历史及现状 #
图在我们身边随处可见, 研究者开发出在图上运行的神经网络(图神经网络, GNN)已经十几年了, 近期有所进展, 我们开始看到在各个领域的实际应用( such as antibacterial discovery , physics simulations , fake news detection , traffic prediction and recommendation systems.)
2.2 文章目的 #
探索和解释图神经网络
2.3 文章架构 #
文章将分为四个部分
- 什么样的数据可以表示成图
- 图和别的数据类型有什么不一样
- 构建一个GNN, 介绍模型的各个部分
- 提供一个GNN的playground, 更好的理解GNN
3. 图(Graph) #
3.1 什么是图 #
A graph represents the relations (_edges_) between a collection of entities (_nodes_).
这句说的是 :
图表示了一些实体之间的关系, 所谓的实体就是一个点(node), 关系就是边(edge)
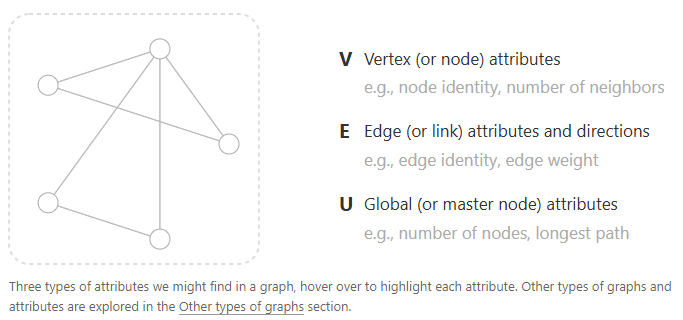
- V : 在这里表示顶点
- E : 在这里表示边
- U : 在这里表示全局, 代表整个图
我们关系的是每个顶点, 每条边, 以及整个图, 所表示的信息, 在这里称作attribute
3.2 如何表示各部分的属性(attribute) #
我们可以通过向量的形式来表示顶点, 边, 以及全局的属性
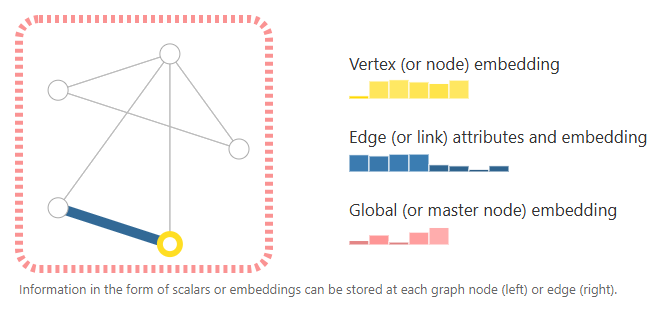
例如图中的顶点(用黄色表示的部分), 可以看到这个顶点中有六个属性, 即六个高矮不同的矩形, 这表示一条向量的六个维度, 所以说用向量(embedding)表示属性(attribute)
3.3 图的分类 #
- 有向图
- 无向图, 两个点之间连的边是没有方向的
3.4 数据是如何表示成图的 #
3.4.1 图片怎么表示成图 #
可以将图片中的每个像素表示成图中的一个点, 如果像素之间存在邻接关系, 就表示成边
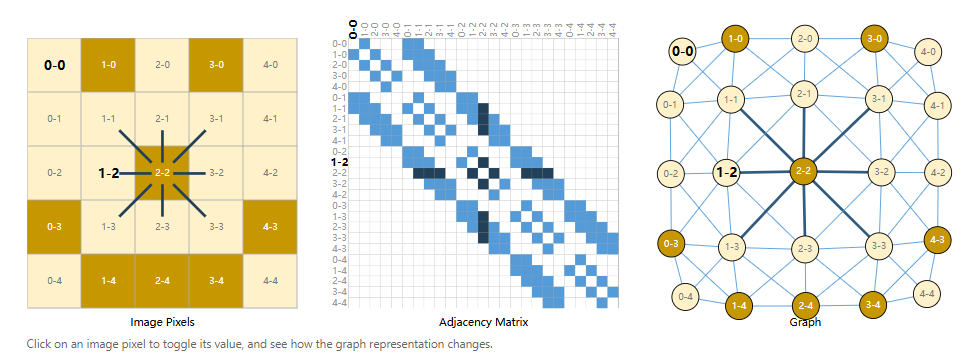
上图中左侧的是原图片, 中间的是邻接矩阵, 右侧的是由图片转换成的图
邻接矩阵中蓝色的点表示 这两点是有边的, 例如图片中的2-2与周围的点都是有边的
所以蓝色点表示的是有一条边,白色点表示没有边, 这就是邻接矩阵, 通常很大很稀疏
3.4.2 文本怎么表示成图 #
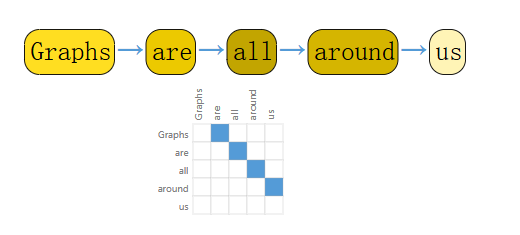
文本可以认为是一条序列, 我们可以把每一个词表示成一个顶点, 每个词和下一个词之间存在一条有向边
3.4.3 生活中其他数据表示成图 #
分子 #
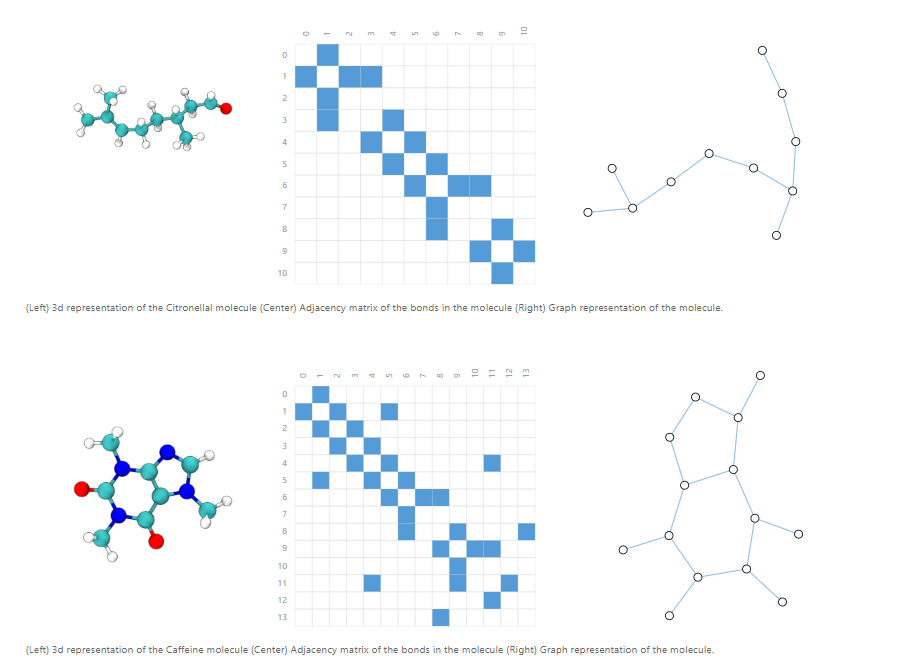
将分子表示成图, 下图分别是香料分子和咖啡因分子的示意图
可以将每个原子表示成一个点, 如果原子间相连, 那就表示成一条边
社交网络 #
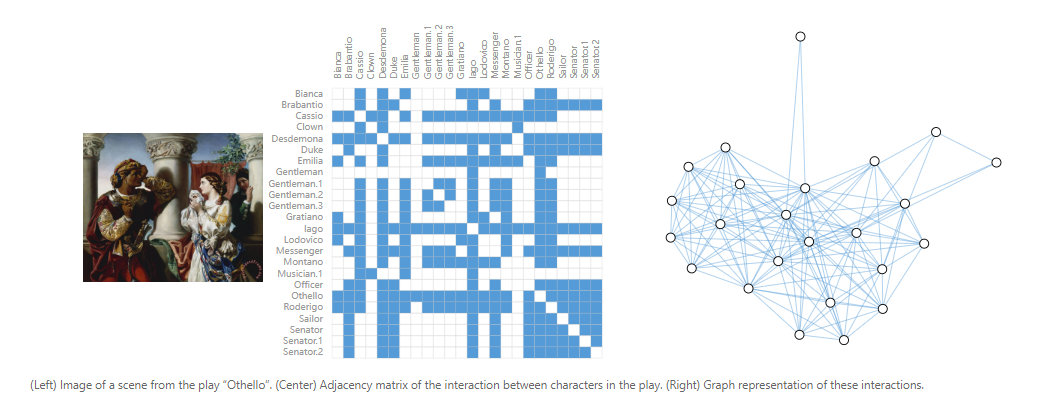
通过图表示«奥赛德»这部剧中的人际关系, 只要人物在同一个场景中出现过, 人物之间就存在一条边
在一个空手道俱乐部中, 有两个老师, 每个老师会去和同学进行一些比赛, 将每一场老师和同学做过的比赛放在一起, 可以得到一张社交的图
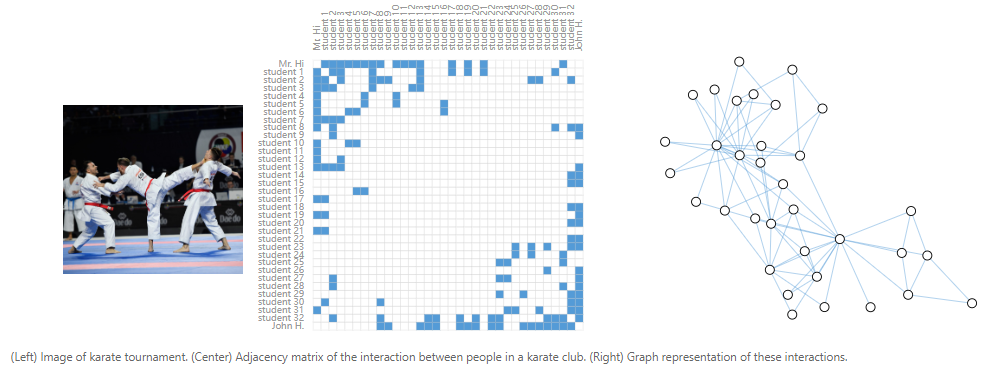
当一篇文章引用另一篇文章时, 这两篇文章之间就存在一条有向边, 因为两篇文章基本不会相互引用
3.5 图结构的数据有什么样的任务 #
3.5.1 图层面的任务 #
给你一些分子结构图, 要求输出哪个分子中存在两个环
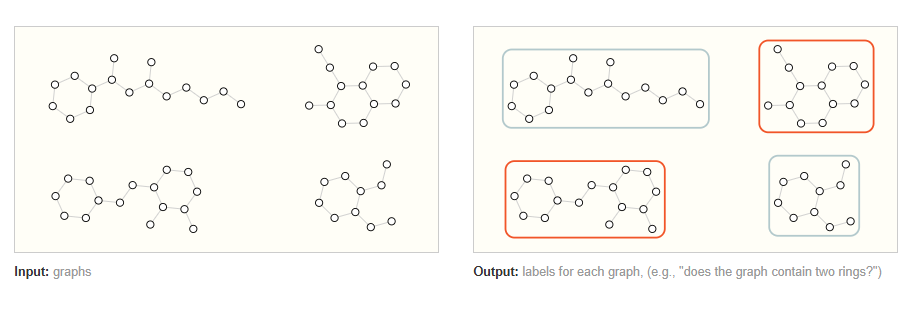
3.5.2 顶点层面的任务 #
引用空手道俱乐部的例子, 有一天两个老师决裂了, 那么哪些学员站在老师A那一方, 哪些学员站在老师B那一方, 需要预测出每个点是哪一方的, 如下图右侧,红色为一方, 蓝色为另一方
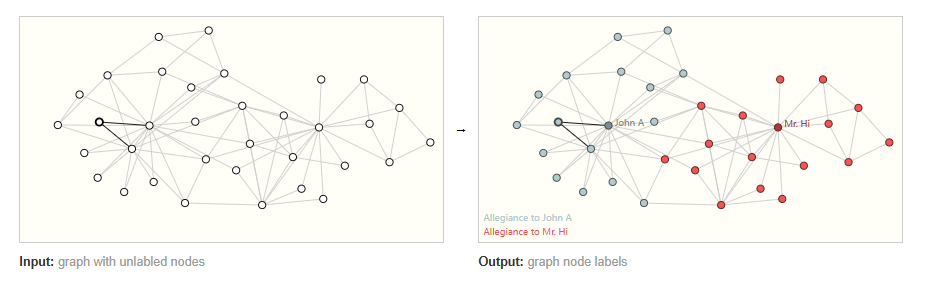
3.5.3 边层面的任务 #
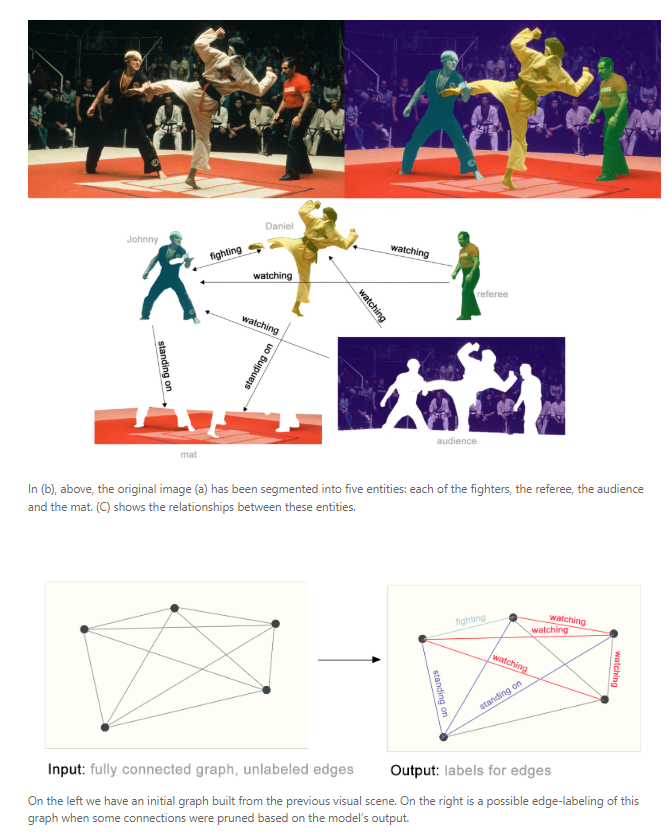
给出一张图片, 通过语义分割将图中的任务, 背景分割出来, 之后要我们判断图中各个人物之间是什么关系
即预测 两个顶点之间的属性
3.6 将机器学习用在图上面会遇到哪些挑战 #
我们在将神经网络用到图上面的时候, 首要的问题就是, 怎么样表示图使其与神经网络兼容
我们知道图上有四种信息
- 顶点属性
- 边属性
- 全局属性
- 连接性 (图里的节点通过边能不能“互相到达”、以及“到达得有多容易”)
3.6.1 存在的问题 #
- 表示图的连接性的时候, 最直接的选择是用邻接矩阵, 但是邻接矩阵非常稀疏, 而且很大, 导致处理起来不能高效, 而且将稀疏矩阵用在GPU上是一个比较难的技术问题
- 邻接矩阵交换任何行或者列的顺序都不会有影响, 那就意味着我们需要设计的神经网络, 向里面放入顺序不同但是表示相同的邻接矩阵的时候, 我们要能够得到相同的结果
3.6.2 解决方法 #
通过邻接表实现稀疏矩阵的高效存储
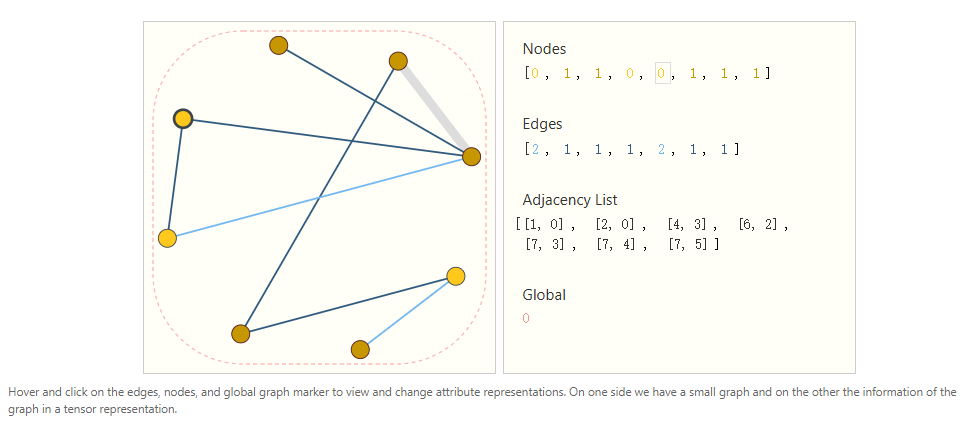
可以看到下图有八个顶点, 七条边
我们可以将每个顶点用标量表示(也可以用向量)
同样的, 每条边和全局也可以用标量表示(也可以用向量)
然后我们维护一个叫做邻接列表的东西(adjacency lists)
adjacency lists 的长度和图中的边数一样, 其中第i项表示第i条边连接的那两个节点
- 这种形式在存储上是高效的
- 这种存储形式与顺序无关, 如果打乱顶点或边的顺序, 只需要在邻接列表中进行对应的更新即可
4. 图神经网络(Graph Neural Networks) #
4.1 定义 #
A GNN is an optimizable transformation on all attributes of the graph (nodes, edges, global-context) that preserves graph symmetries (permutation invariances).
就是说图神经网络是对图上所有属性(包括顶点, 边, 全局上下文)进行的可优化的变换, 这个变换是能保存图的所有对称信息的, 意思就是把图的顶点,边的顺序进行调换之后, 结果是不会变的
这里文章作者表示接下来将用信息传递神经网络(“message passing neural network”) 来构建GNN
GNN是“graph-in, graph-out”, 即输入图, 输出图 的架构, 会对顶点, 边,全局上下文进行变化, 但不会去改变图的连接性
4.2 举例构造最简单的GNN #
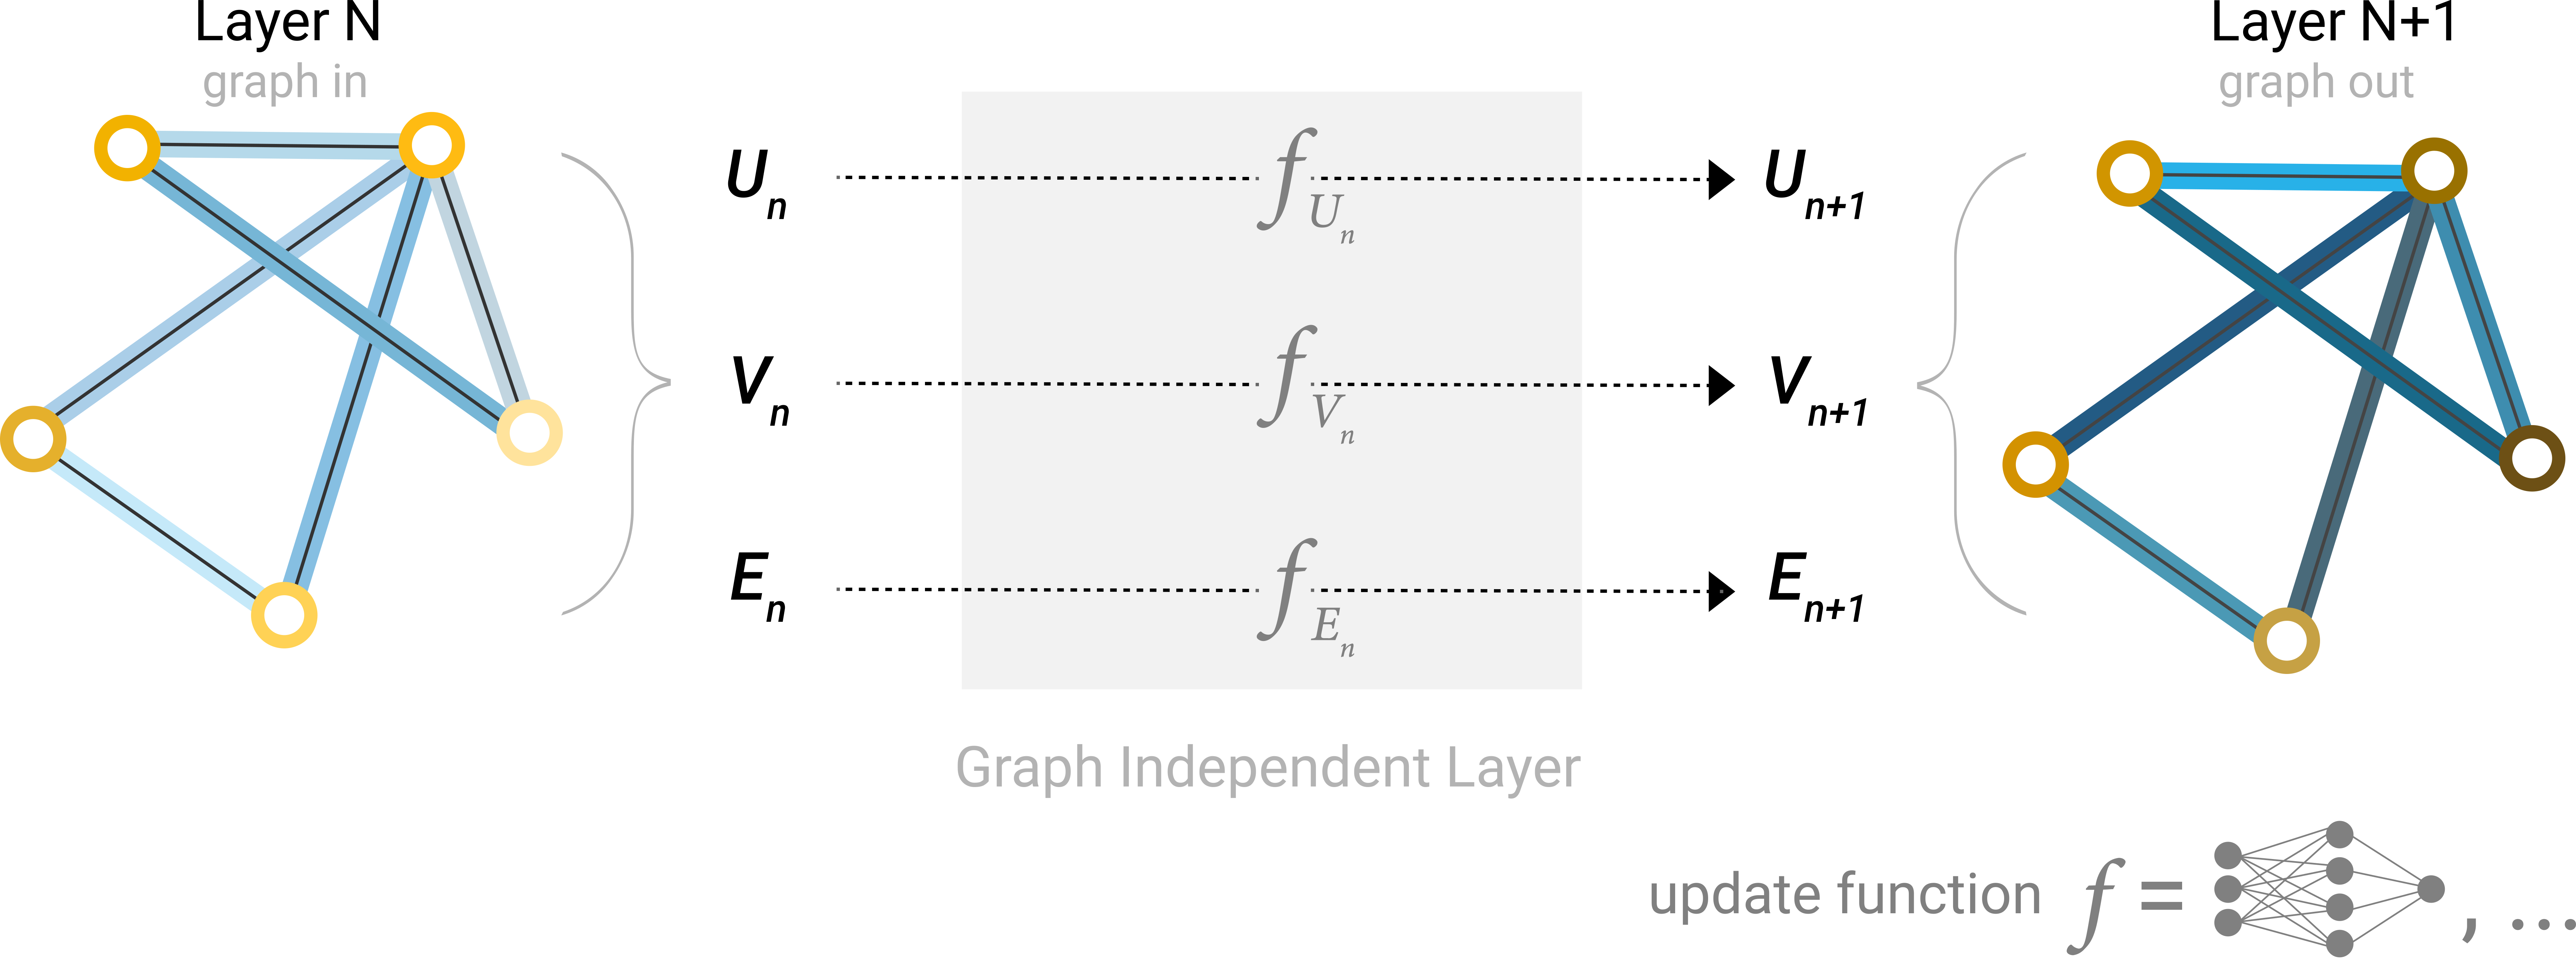
对于顶点, 边, 全局向量, 分别构造一个MLP(多层感知机)
然后这三个MLP就组成了一个GNN的层
就是我们对于顶点, 边, 全局向量, 分别找到对应的MLP, 把数据放进去 然后得到输出
这样我们就能实现输入一个图, 然后输出一个属性被更新过的, 但是图的结构不变的图, 满足了第一个要求(只对属性进行变换但是不改变图的结构)
然后因为MLP是对每一个向量独立作用的, 不会考虑连接信息, 所以即使对顶点之类的进行排序, 也不会改变结果, 满足了第二个要求
然后把这些层叠加在一起可以得到比较深的GNN
4.3 怎样进行预测 #
还是引用前面的空手道例子, 如何判断一个学员效忠于A还是B
显然, 这是一个二分类问题(模型要在两个类别之间做选择)
那我们就在GNN的最后一层得到的顶点的向量后面加一个输出为2的全连接层(就是下图中的C_v), 再加一个softmax就可以得到结果
由这个二分类就可以引申到多类的问题, 那就是加输出为n的全连接, 再加softmax, 得到多类输出
对于回归的问题就是加输出为1 的全连接层
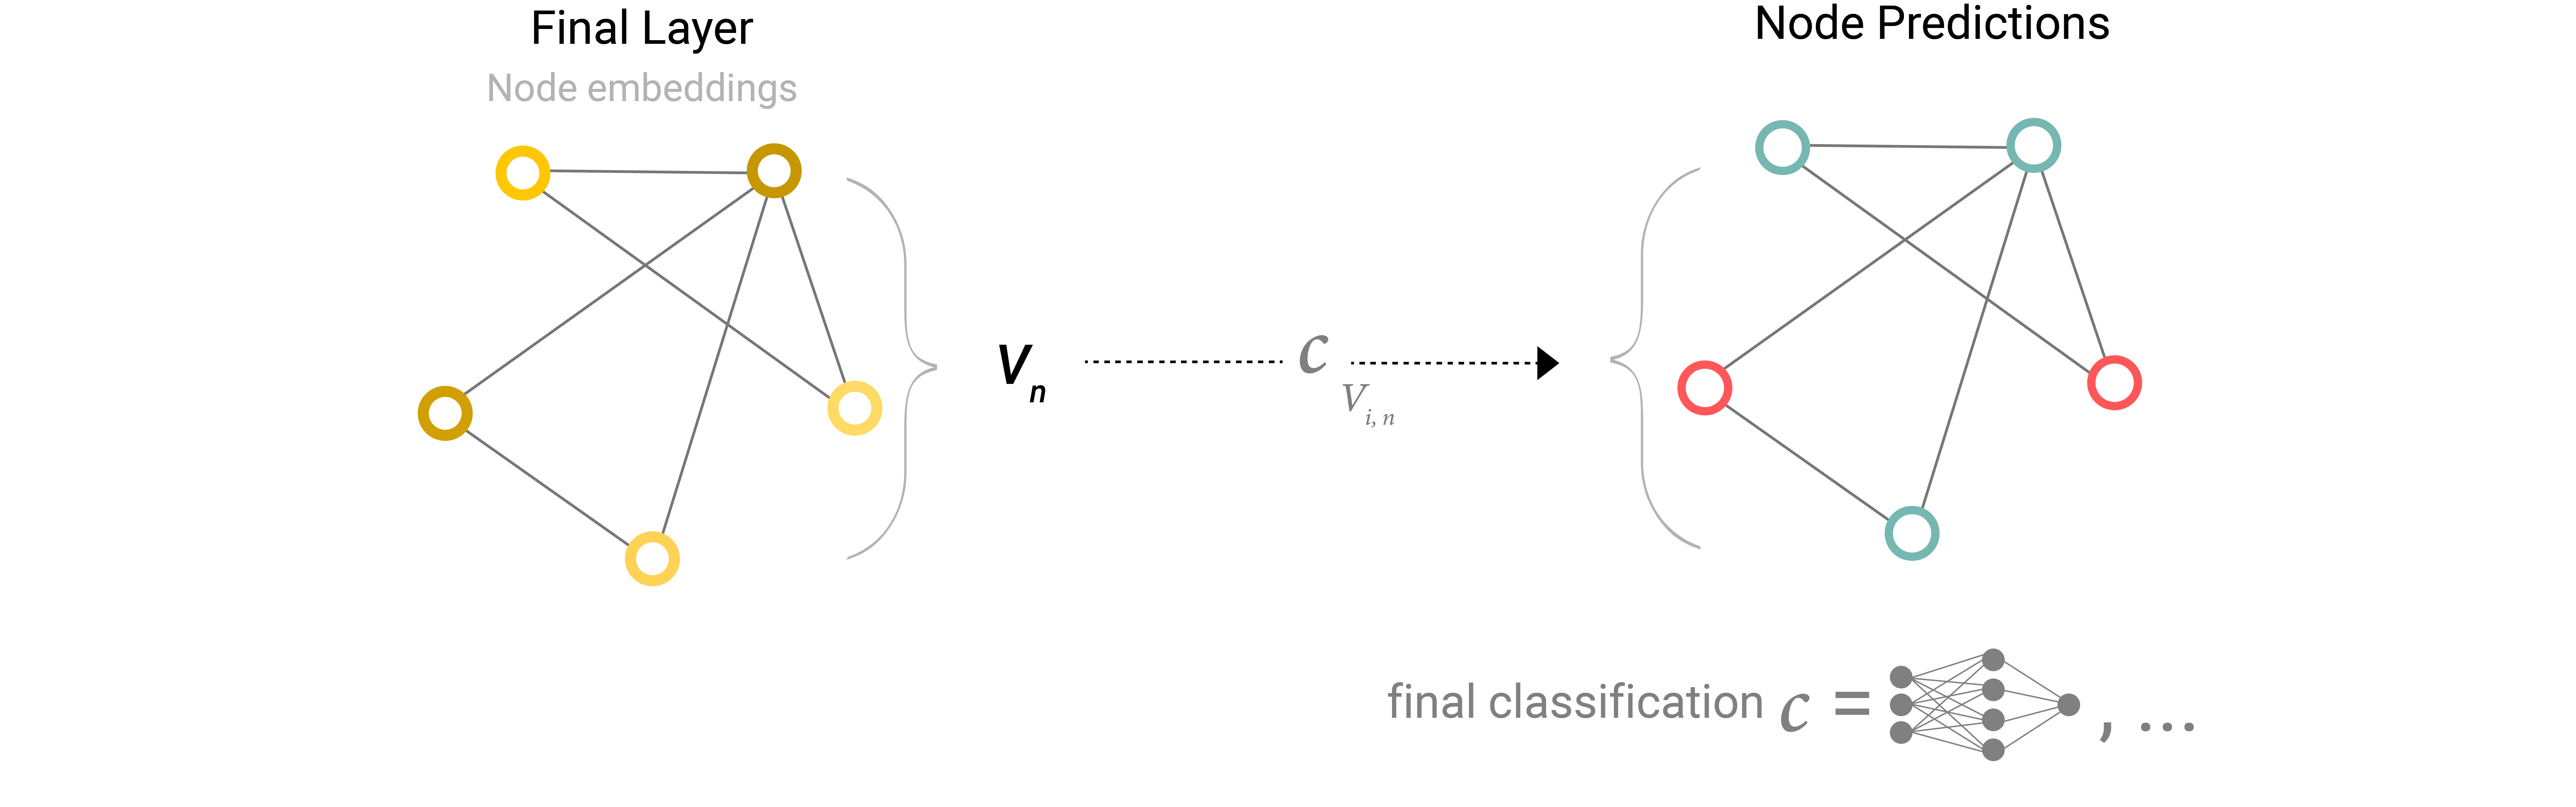
这种情况只有一个全连接层, 也就意味着所有的顶点共享一个全连接层
4.3.1 补充 #
全连接层 :
简单来说就是加权求和, 将顶点的各个属性乘上不同的权重, 这个权重是跟结果关联的, 最后得到一个输出
对于输出为2 的全连接层, 最后会得到两个输出, 在上面的例子中就是效忠于A的分数和效忠于B的分数
Softmax :
核心是先取指数, 再归一化
例如我输出为2的全连接层输出的分数是3和7
- 先取值数e^3 ≈ 20, e^7 ≈ 1096
- 归一化 总和 ≈ 20 + 1096 = 1116
- 变成概率: p₁ ≈ 20 / 1116 ≈ 0.018
p₂ ≈ 1096 / 1116 ≈ 0.982 - 选概率大的类别
softmax的特点 : 会放大大的值,压缩小的值
4.4 稍微复杂的情况:缺失属性时怎么办(Pooling / 汇聚) #
假设我想对一个顶点做预测, 但是我没有这个顶点的向量怎么办
这时候需要用到 pooling (汇聚),
做法是将这个点相连的边和全局的向量加起来 ,如下图, 这样就得到这个点的向量, 当然这里的顶点,边,全局的向量维度是一样的, 不一样的话就投影
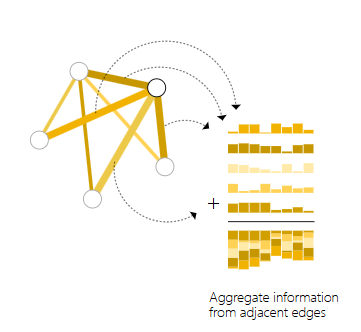
同理,假设没有边的向量, 只有顶点和全局的向量, 我们可以把这两个顶点的向量加起来, 也可以加上全局向量, 得到这个边的向量, 然后进入边向量的输出层, 得到边的输出
一样的, 假设没有全局的向量, 我们可以把顶点和边的向量加起来, 得到全局向量, 再放入全局的输出层, 得到全局的输出
意思就是不管缺少哪一类属性, 都可以通过汇聚这个操作得到所需要的属性, 从而得到预测值
4.5 结合前两部分得到的最简单的GNN(总流程) #
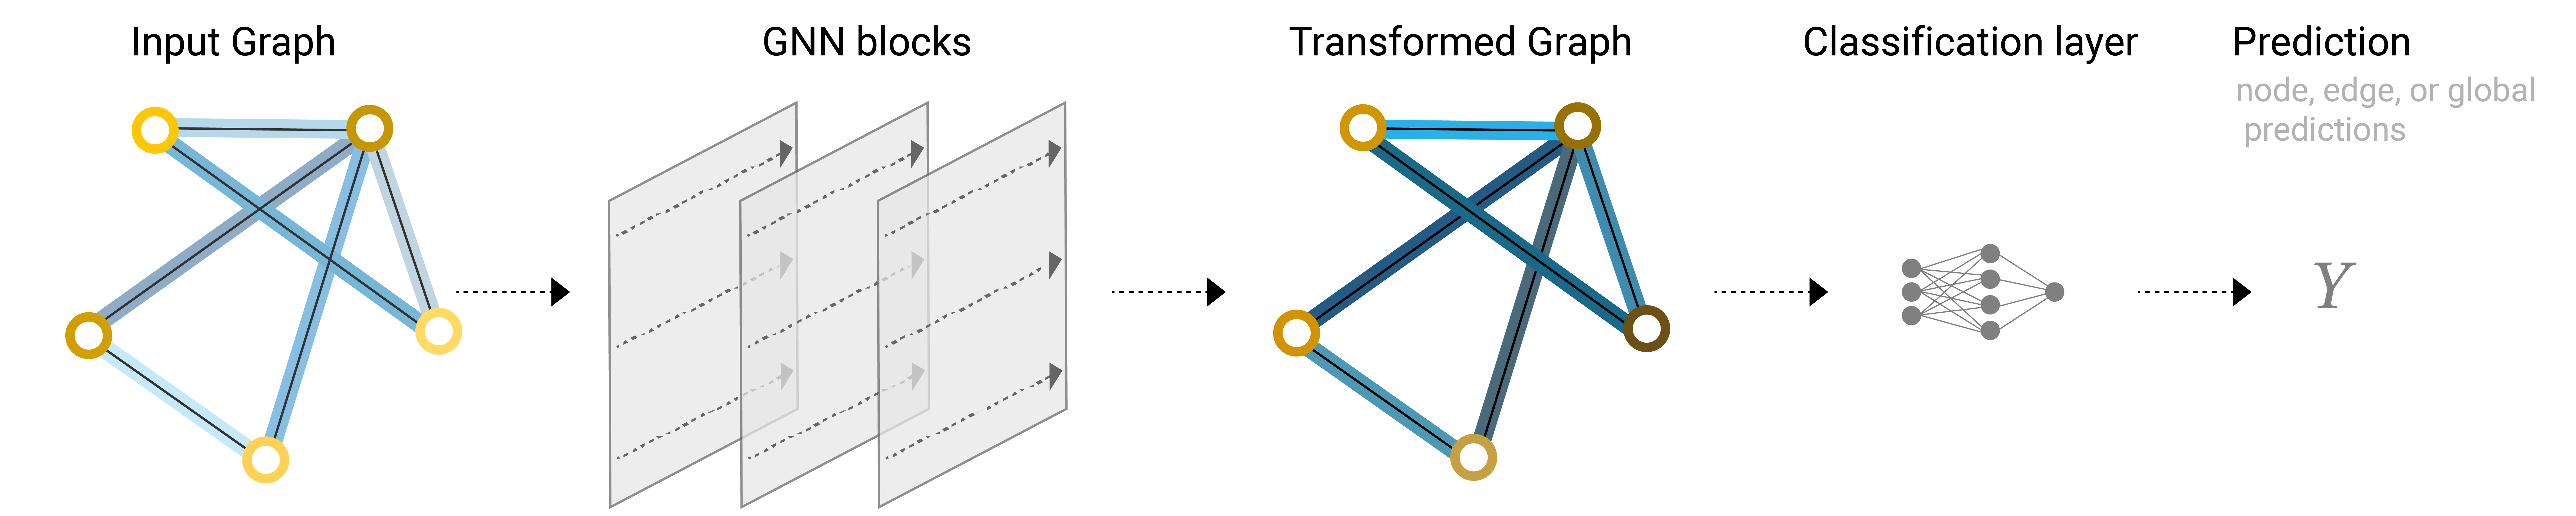
- 首先得到一个输入的图
- 进入GNN层, 每个层有三个MLP (对应三种不同的属性)
- 输出 保持图的结构, 但是所有属性已经进行变换的图
- 根据你要对哪个属性做预测, 添加合适的输出层
- 但是如果缺失信息的话, 就添加合适的汇聚层
- 最终完成预测
4.5.1 存在的局限性问题 #
在GNN中并没有使用到图的结构信息, 就是当我们对每个属性做变换的时候,每个属性是独立的进入对应的MLP, 并没有用到所谓的"这个顶点是和哪条边相连"这些信息, 导致结果并不能合理的把整个图的信息更新进属性里面, 导致结果不能充分利用图中的信息
4.5.2 改进方法:通过信息传递(Message Passing) #
通过信息传递进行改进
- 在之前, 我们是直接将一个顶点的向量放入MLP, 变换之后的到更新的向量
- 在信息传递中, 我们将目标顶点的向量和邻接的两个向量加在一起得到一个汇聚的向量, 再将其放入MLP, 得到更新的向量
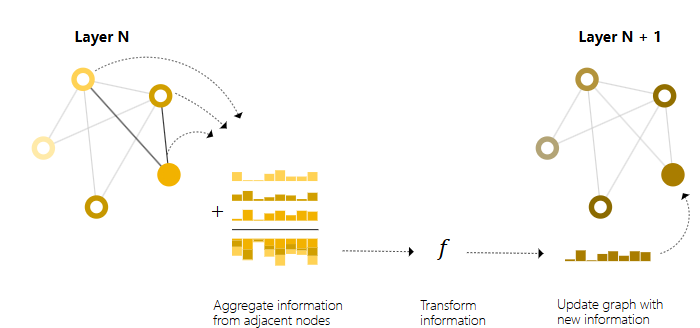
这种方法类似于图片上的卷积, 但是区别是卷积的话每个向量有自己的权重, 而这种方法每个向量的权值相同
这种方法就让我想到了文章开头的那个交互图
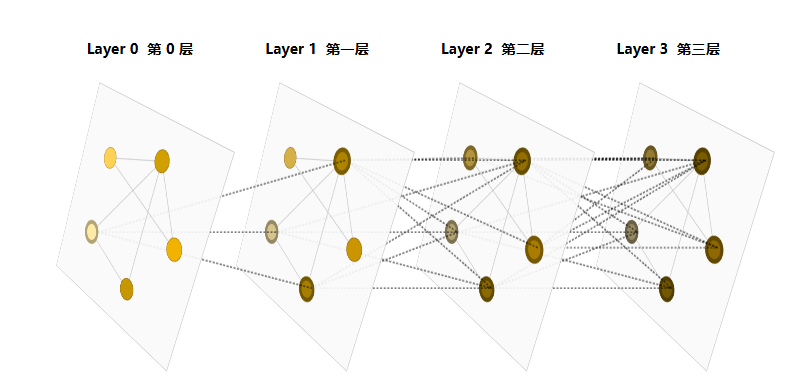
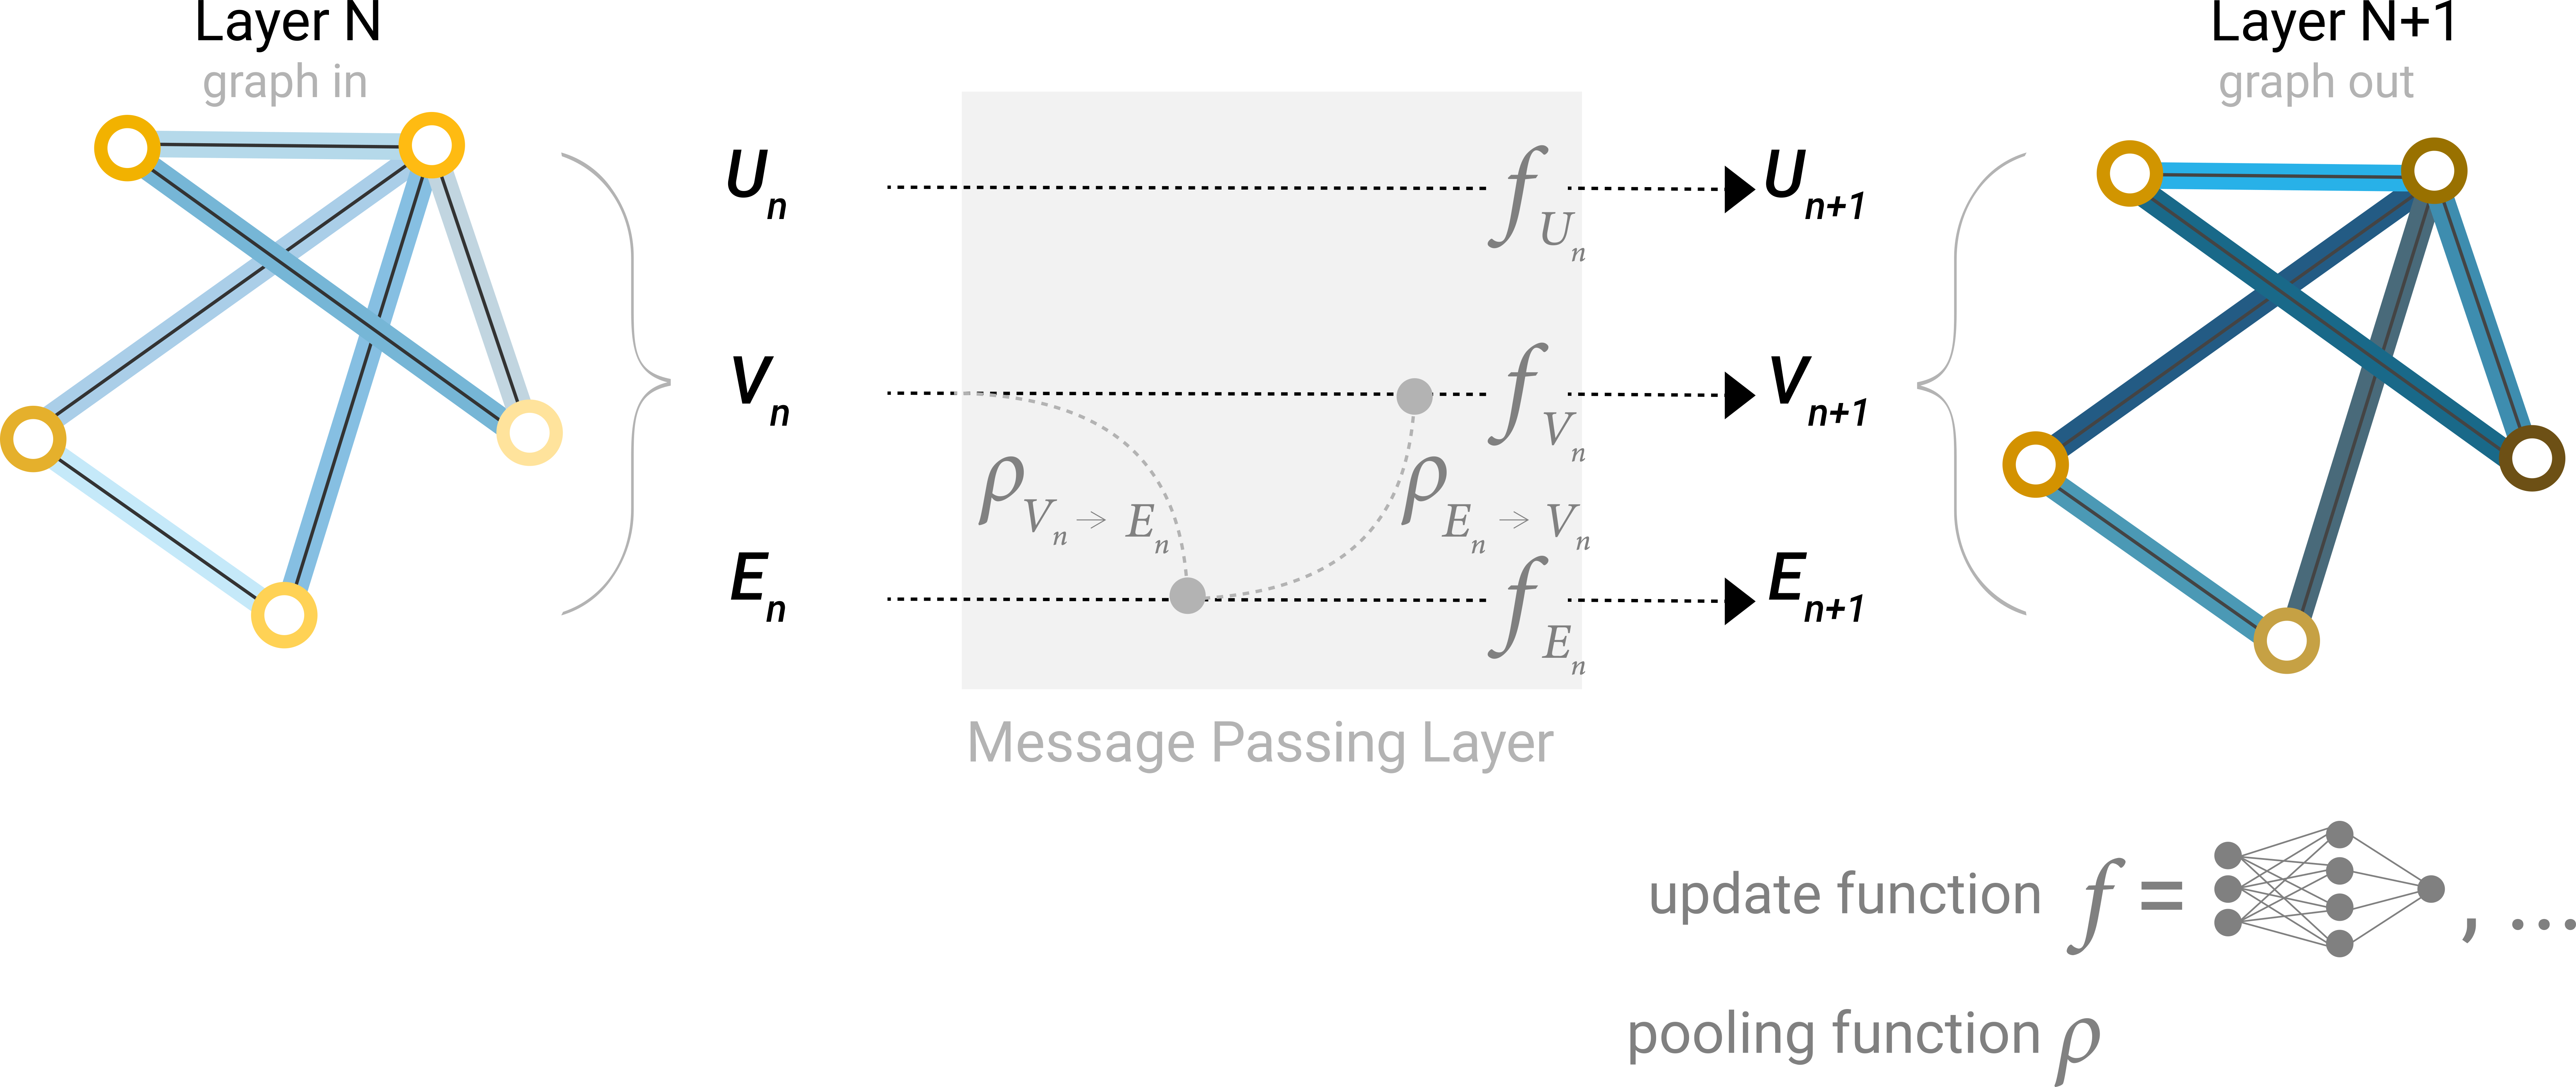
这张图就表示了这种方法, 中间部分表示将与顶点距离为1 的点汇聚过去
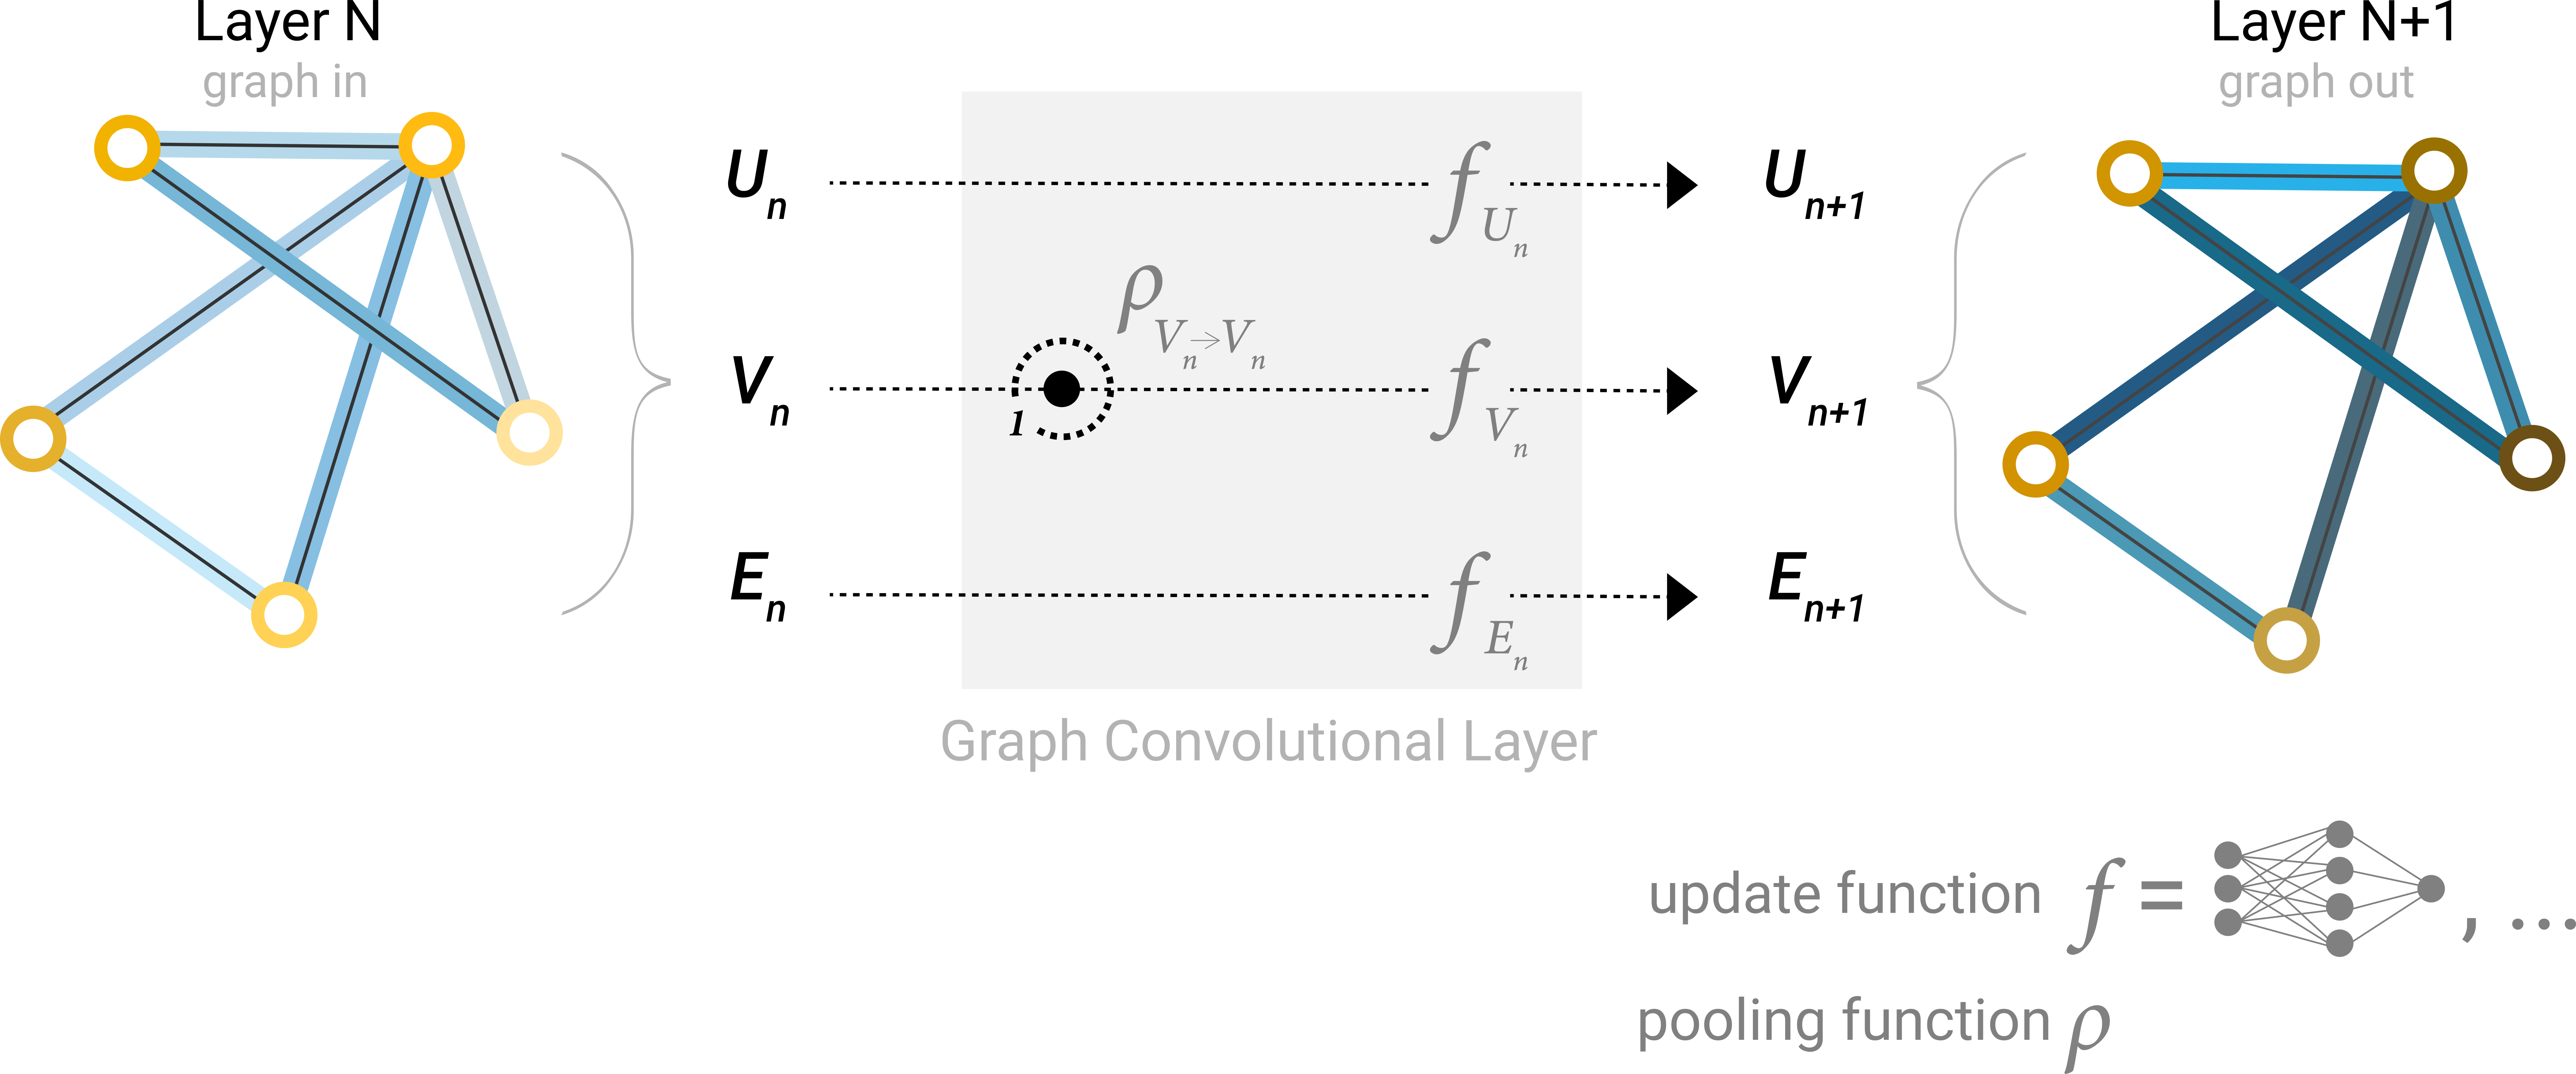
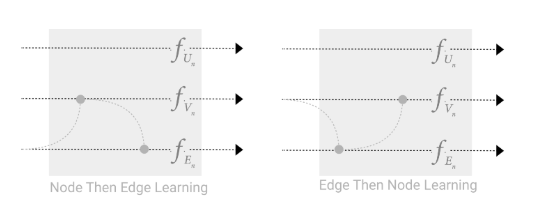
更加复杂一点, 可以在比较早的时候, 在边和顶点之间做汇聚, 先将顶点的属性汇聚到边上, 再将边的属性汇聚到顶点, 如果顶点和边的向量维度不一样的话就进行投影
注意 : 下图中表示的是两种不同的办法, 而且这两种办法得到的结果是不一样的!
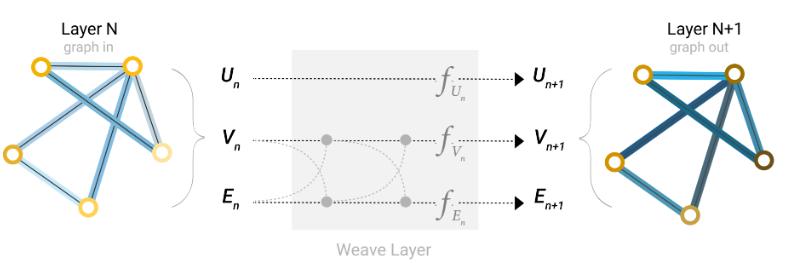
作者在这里提出了以下方法
边和节点同时基于节点和边的原来的属性进行更新
4.6 全局(Global / U) #
有一个master node 跟所有的顶点和边都相连, 这个抽象的东西就是U
所以当我们将顶点的信息汇聚给边的时候, U的信息也会参与其中
当U自身更新时,所有顶点和边的信息都会参与
5. Playground #
自己去用一下就好, 没什么好记的 其实这篇文章看到这个部分就差不多了, 再之后我不想看了
6. 一些其他东西 (没什么可看的) #
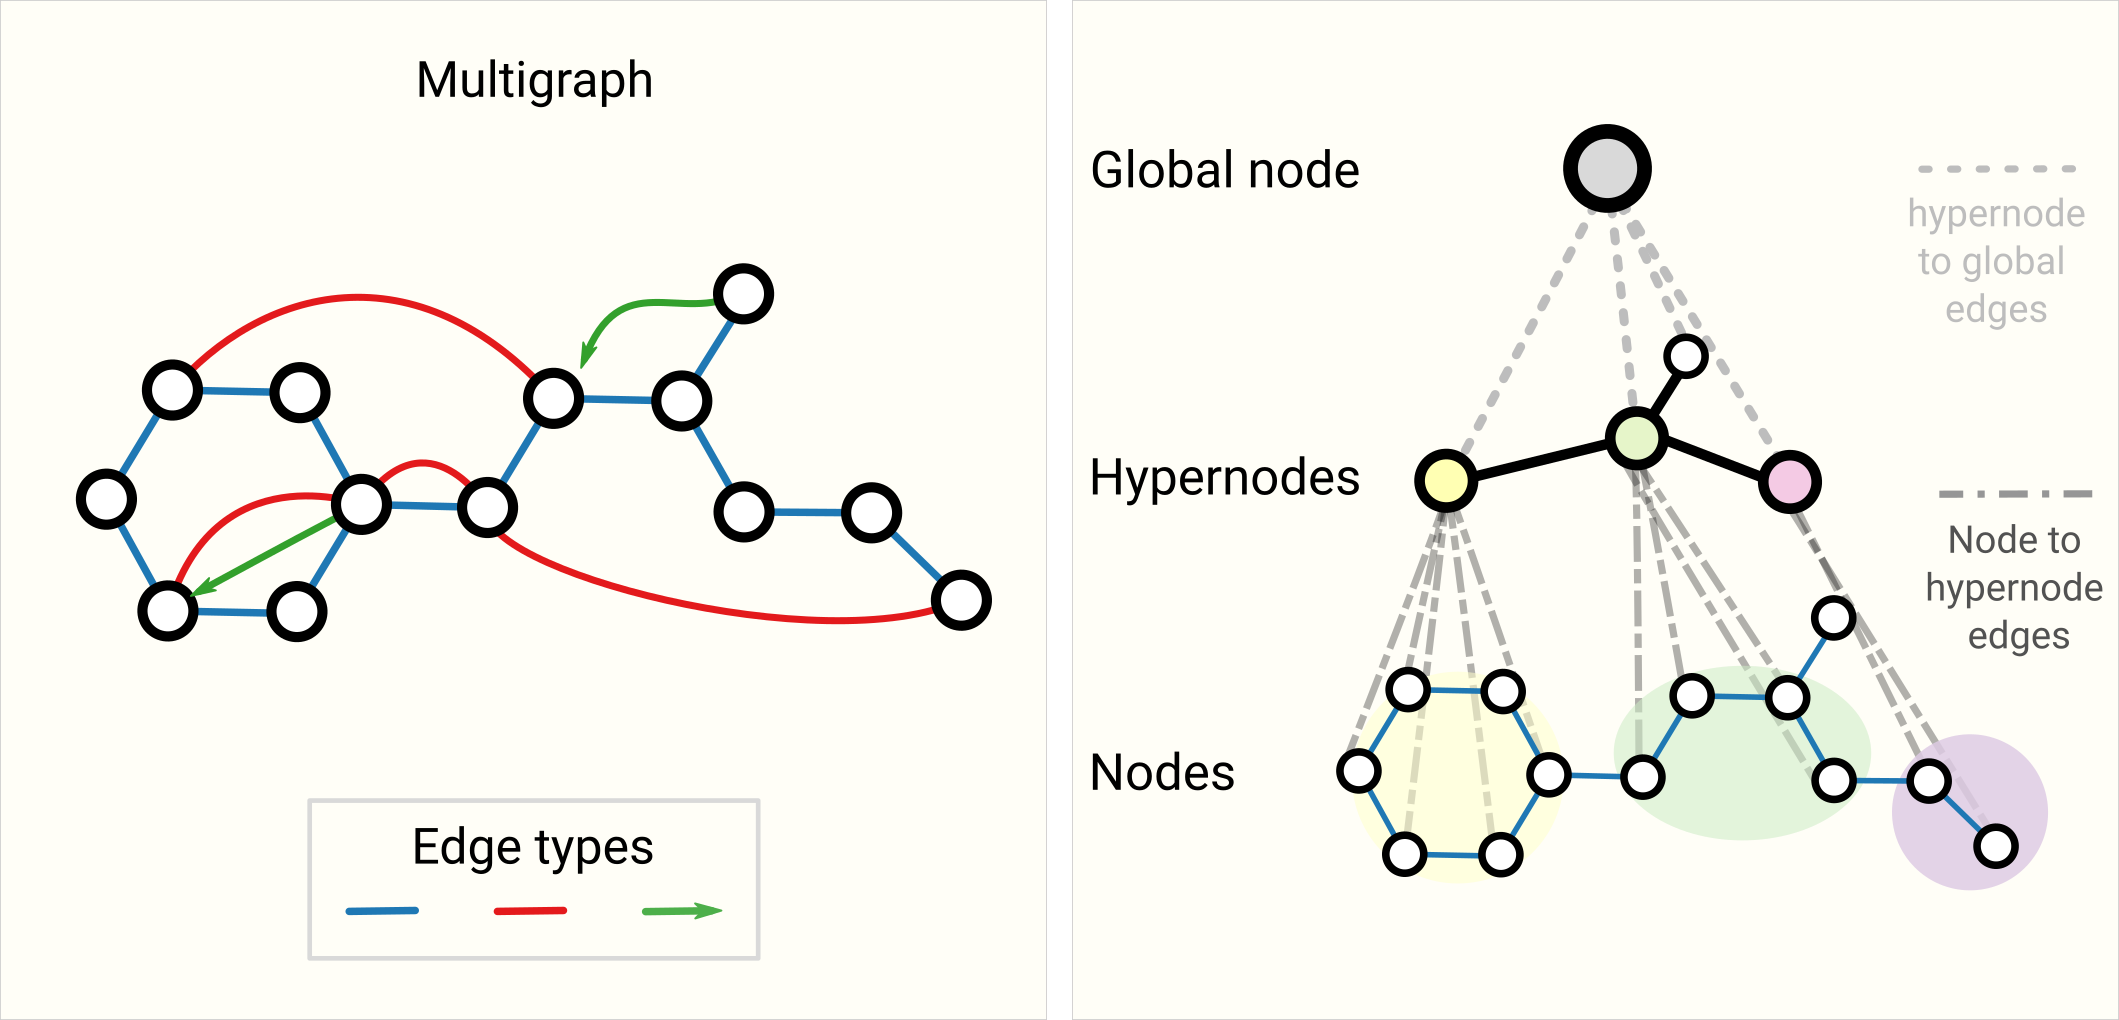
6.1 其他类型的图 #
有的图的节点之间可能有不同种类的边
有的图会有多层结构
6.2 采样 #
6.2.1 为什么要采样 #
1. 解决“邻居爆炸”问题 (Neighbor Explosion) #
GNN 的核心是聚合邻居信息。假设一个图中每个节点平均有 10 个邻居:
- 在 1 层 GNN 中,更新一个节点需要 10 个邻居的信息。
- 在 2 层 GNN 中,需要邻居的邻居,信息量变为 $10 \times 10 = 100$。
- 在 3 层中,就变成了 1000 个。
如果图中存在“超级节点”,不加控制地聚合会导致单次计算瞬间撑爆内存。采样可以将这种指数级增长控制在固定规模内。
2. 实现批处理 (Mini-batch Training) #
深度学习的成功很大程度上归功于 SGD(随机梯度下降),它要求我们将数据切分成一个个小批次(Batch)。
- 非图数据:图片与图片之间是独立的,随手一抓就是一个 Batch。
- 图数据:节点之间互联。如果你随机抓 100 个节点,它们可能散落在图的各个角落,彼此没有连接。
- 采样意义:通过采样(如邻域采样),我们可以人为地构造出许多个**“小型子图”**。这些子图既能代表原图的结构,又能塞进固定的 Batch Size 中进行并行计算。
3. 提高计算效率与硬件适配 #
由于 GPU 的显存有限,我们无法一次性将包含数亿个节点和边的巨型图(比如微博、淘宝的推荐图谱)放入显存中。
- 全图训练 (Full-batch):计算一次梯度要等全图跑完,速度极慢。
- 采样训练:允许模型在每一轮迭代中只处理图的一小部分,大大加快了收敛速度,并使得在普通消费级显存上训练超大规模图模型成为可能。
4. 引入随机性以增强泛化能力 #
采样本质上也是一种数据增强(Data Augmentation)。
- 在每一轮训练(Epoch)中,节点看到的邻居子集可能略有不同。
- 这种随机性可以防止模型过分依赖某些特定的路径,从而提高模型的鲁棒性(Robustness),减少过拟合。
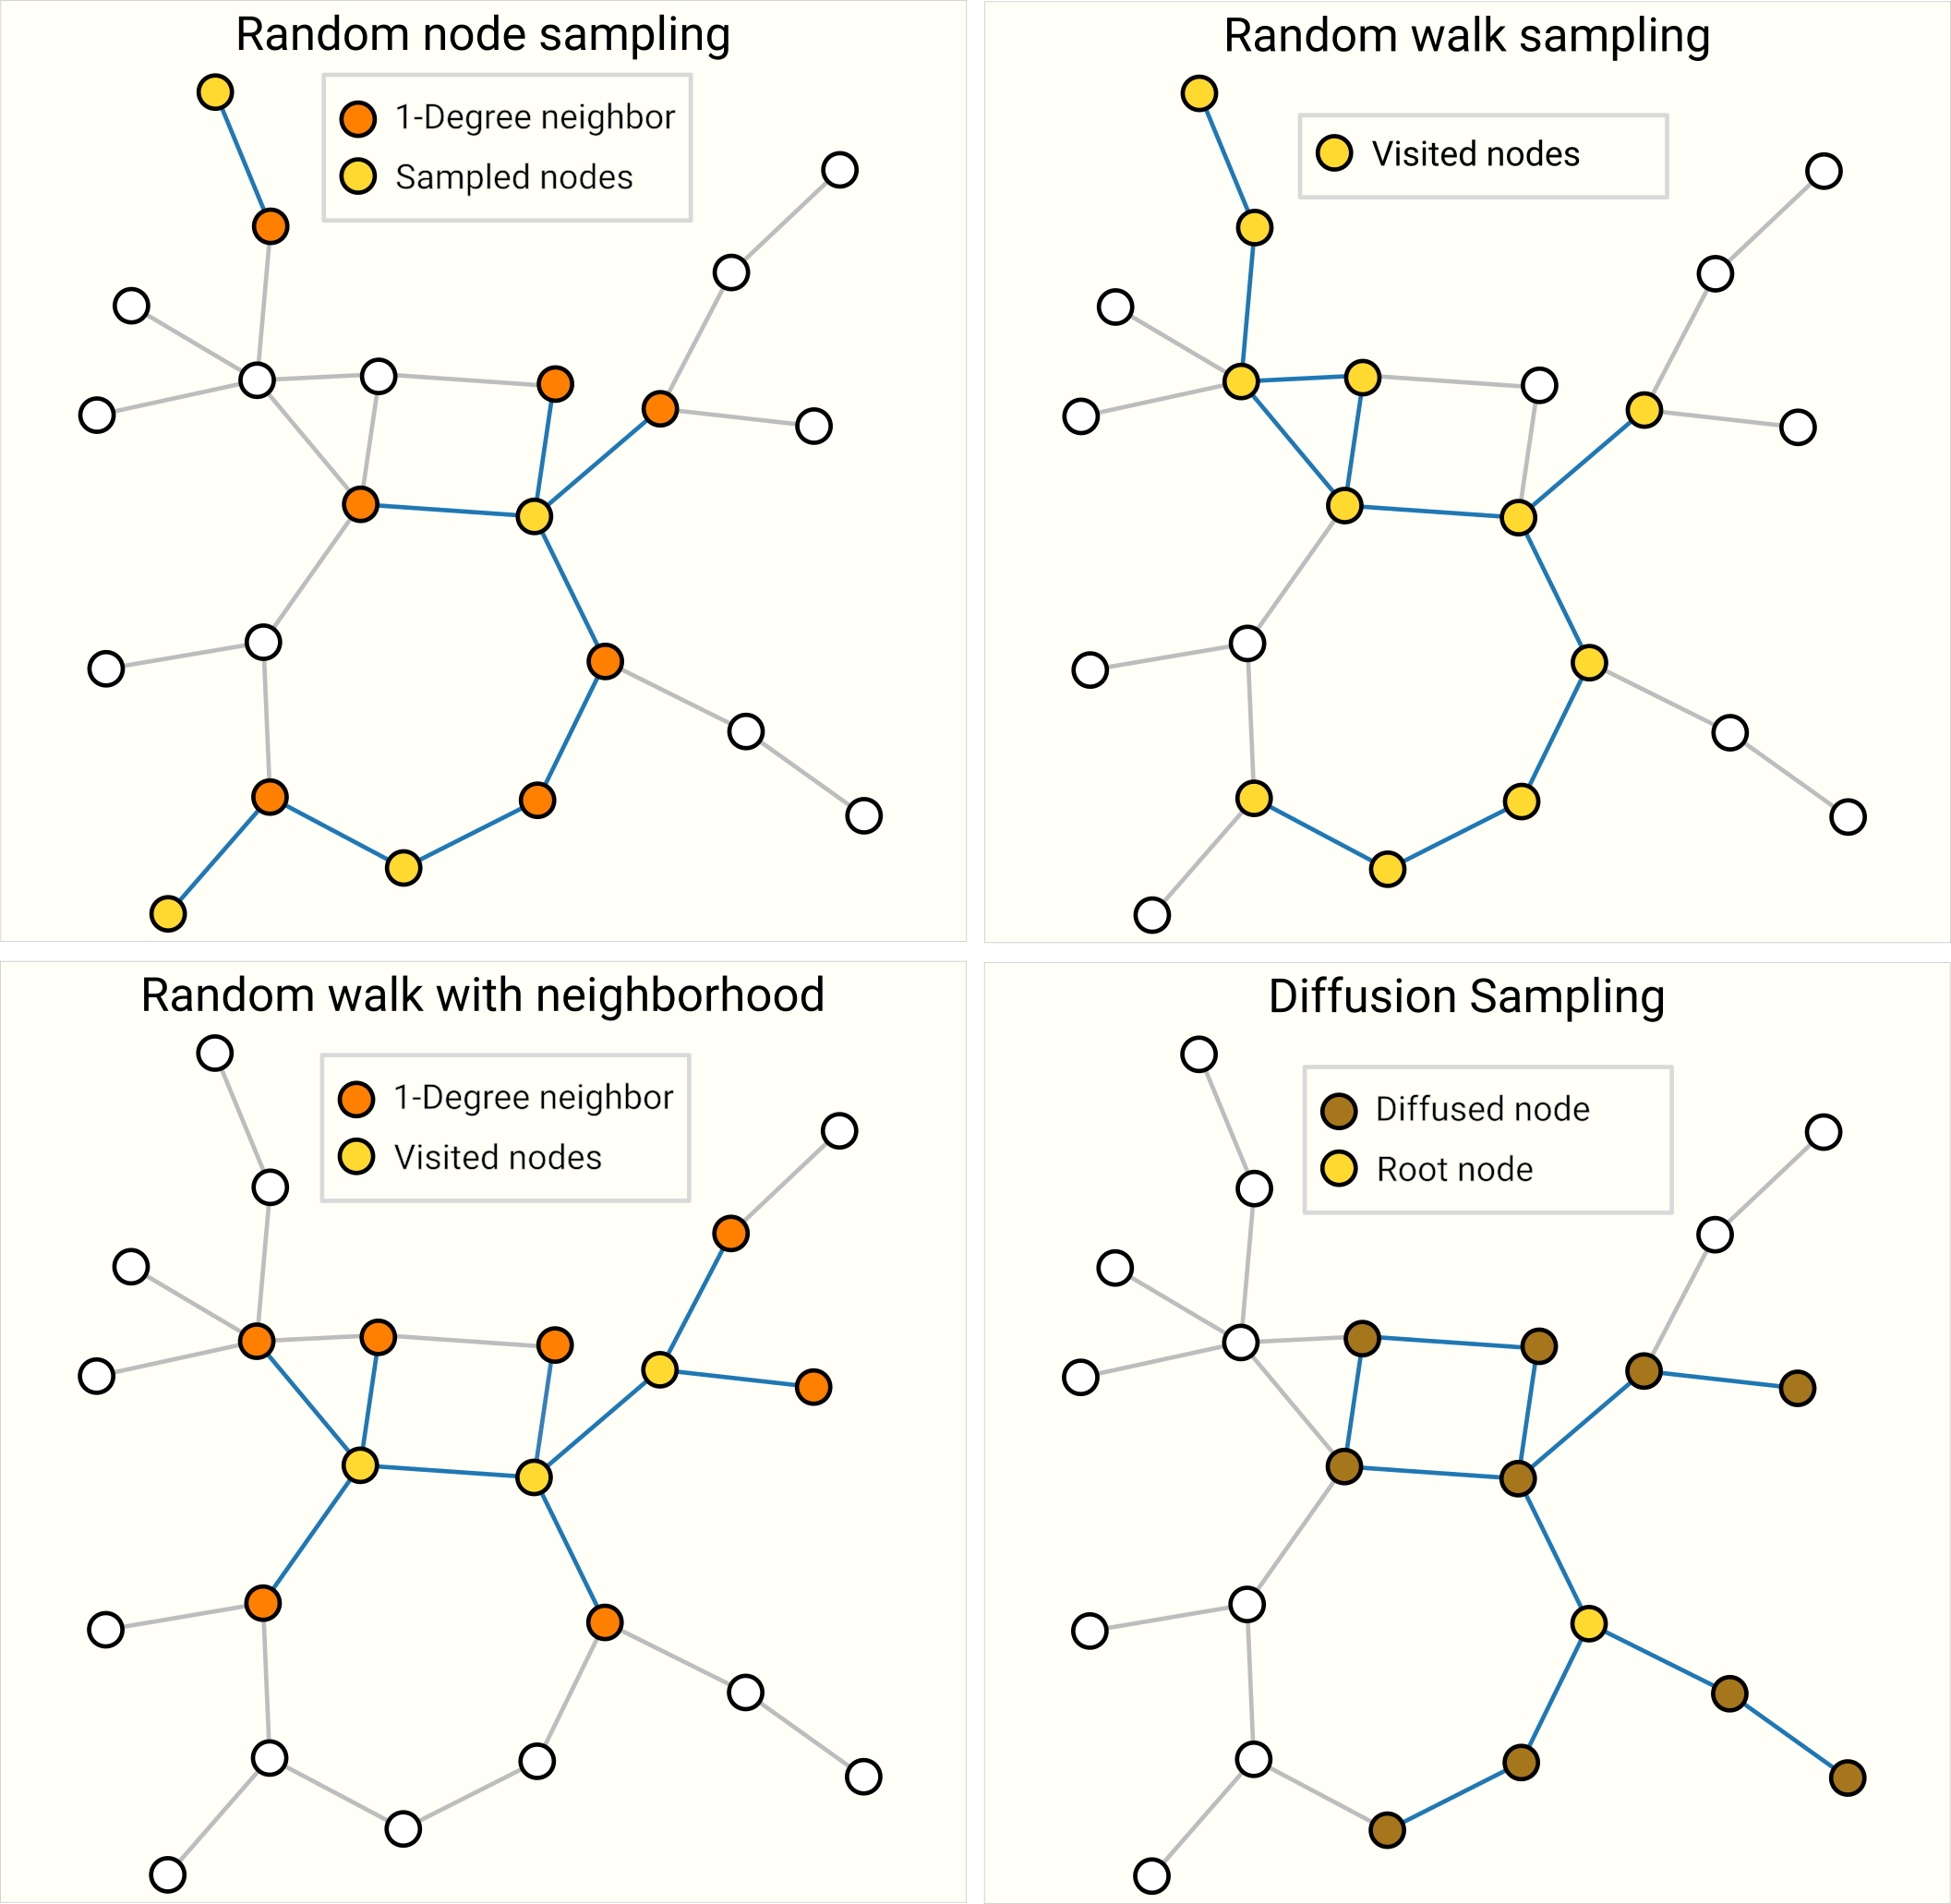
6.2.2 方法 #
1. 邻居采样 (Neighbor Sampling) #
- 核心机制:从目标节点开始,随机选取固定数量(例如图中选了 2 个)的直接邻居。
2. 层采样 (Layer Sampling) #
- 核心机制:在 GNN 的每一层中,从上一层已选节点的邻居集中,全局采样出一组固定数量的节点。
3. 游走采样 (Walk Sampling) #
- 核心机制:从目标节点出发,利用随机游走 (Random Walk) 算法(如 Metropollis),沿着边“走”出一条路径,路径上的节点即为采样点。
4. 自我网络采样 (Ego Sampling) #
- 核心机制:选取一个中心节点(Ego),并将其 $k$ 阶邻域内的所有节点和边全部纳入采样集。
6.3 归纳偏置(Inductive Bias) #
指学习算法在面对同样的训练数据时,为了预测未知数据而作出的一系列假设。
6.3.1 作用 #
1. 解决“泛化”问题 (The Power of Generalization) #
这是最关键的作用。泛化是指模型处理“没见过的数据”的能力。
- 没有假设的情况:如果你给模型看 100 张猫的照片,它只会死记硬背这 100 张照片的像素。当你给它第 101 张(猫稍微歪了下头)时,它会觉得这是一个完全陌生的东西。
- 有了假设(如 CNN 的平移不变性):模型预先被告知“不管猫在左边还是右边,特征是一样的”。这样,它就能从有限的例子中总结出规则,从而识别出从未见过的猫。
2. 缩小“搜索空间” (Narrowing the Search Space) #
机器学习的本质是在无穷无尽的“函数”中寻找最正确的那一个。
- 没有假设:搜索空间是无限的。模型可能会认为“照片左上角有一个红点”就是“猫”的定义,从而陷入无数种错误的逻辑里。
- 有了假设:假设就像是一个过滤器。比如线性回归的假设(世界是线性的),直接把所有曲线、折线的可能性都过滤掉了。模型只需要在“直线”这个极小的范围内寻找最优解,效率呈几何倍数提升。
3. 降低对数据量的依赖 (Data Efficiency) #
这就是为什么有些模型是“天才”,有些是“笨蛋”。
- 强偏置模型 (如 CNN):因为内置了对图像结构的理解,它可能只需要几千张图就能识别物体。这叫“自带常识”。
- 弱偏置模型 (如 Transformer 或 MLP):它对数据几乎不抱任何偏见。好处是它上限极高,坏处是它极度“贪吃数据”。它需要数亿条数据才能通过自我磨炼,慢慢悟出“原来近距离的像素更相关”这个简单的道理。
6.4 汇聚操作的比较 #
- max
- mean
- sum
6.5 GCN 作为子图函数逼近器 #
这个不想看了, 直接看GCN的文章去吧
7. 总结 #
这篇笔记围绕《A Gentle Introduction to Graph Neural Networks》梳理了从“什么是图”到“如何构建GNN”的完整入门路径,核心脉络可以概括为:
图是什么、能表达什么
图用 节点(nodes) 与 边(edges) 表达实体及其关系,并且可以为节点、边、全局(U)分别附加属性(attribute/embedding)。现实中的图片、文本、分子、社交网络、引用网络等都可以抽象为图结构数据。图上任务的三种粒度
图数据常见任务可分为:
- 图层面任务(graph-level):对整张图分类/回归(例如分子是否含有特定结构)。
- 节点层面任务(node-level):对每个节点预测类别/数值(例如空手道俱乐部阵营预测)。
- 边层面任务(edge-level):预测节点对之间的关系或边属性。
- 把神经网络用到图上的关键挑战
主要难点在于:
- 连接性表示(邻接矩阵大且稀疏,GPU上不易高效处理);
- 置换不变性/对称性(节点或边的排列顺序改变不应影响结果)。
文中给出的直观解决方向是用 邻接表(adjacency lists) 来高效存储稀疏连接关系,并在模型设计上保持对节点/边排列的鲁棒性。
GNN 的基本定义与“最简单”的雏形
GNN 可以看作对图中所有属性(节点、边、全局)进行可优化变换的网络,并且要保持图的对称性。最简单的构造方式是:分别对节点/边/全局属性用独立的 MLP 做变换,堆叠多层后得到 “graph-in, graph-out” 的结构(更新属性但不改变连接性)。预测头(readout)与 pooling 的作用
针对二分类、多分类、回归等任务,可以在最后一层节点表示后接全连接层 + softmax(分类)或线性层(回归)。当缺失某类属性(没有节点向量/边向量/全局向量)时,可以通过 pooling/汇聚 将相邻结构的信息聚合得到所需表示。从“独立MLP”到“信息传递(Message Passing)”的改进
朴素MLP方式没有真正利用图结构。改进思路是通过 邻域聚合/信息传递:将目标节点与其邻居(以及可能的边、全局U)信息汇聚,再输入MLP更新,从而让表示随层数逐步融合更远距离的结构信息;全局U可以用类似“master node”的方式与所有节点/边交互。扩展主题:采样与归纳偏置
为解决邻居爆炸、实现mini-batch训练、提升效率并增强泛化,图学习常用邻居采样、层采样、随机游走采样、ego采样等策略;同时也强调归纳偏置对于缩小搜索空间、提升数据效率与泛化能力的重要性。
总体而言,这篇文章/笔记提供了一个清晰的入门框架:图的表示 → 图任务类型 → 图学习挑战 → GNN 的基本结构 → pooling 与 readout → 信息传递机制 → 工程训练中的采样与偏置。如果后续要继续深入,可以从 GCN/GraphSAGE/GAT 等经典模型与它们对应的聚合函数、归一化与采样策略开始系统阅读。